
Человек открывает ChatGPT и пишет: «какую веб-аналитику без cookie выбрать для интернет-магазина, чтобы данные хранились в России». В ответ получает три названия, по фразе о каждом и ссылку-другую. Переходит по одной из них. Это и есть весь путь покупателя: ни страницы результатов, ни прокрутки, ни второго мнения.
Если ваш бренд среди этих трёх, вы только что получили клиента. Если нет, вы не потеряли позицию: вас просто не было в комнате. А аналитика ничего об этом не скажет, разве что «прямые заходы» в прошлом месяце немного подросли.
Коротко:
- Видимость в ответах ИИ — это доля покупательских вопросов, в ответ на которые модель называет ваш бренд. Её считают по каждому вопросу, модели и конкуренту.
- Задайте 20–30 настоящих вопросов покупателей, каждый по три раза, каждой важной для вас модели, и показывайте разброс рядом со средним.
- Отслеживайте семь показателей: упоминания, позицию, ссылки, рекомендации, индекс доминирования, корректность и разброс.
- Прежде чем писать новые страницы, проверьте, могут ли ИИ-краулеры вообще прочитать сайт. Низкая видимость обычно упирается в технику.
- Измеряйте и вторую ось: переходы из ИИ-ассистентов отдельным каналом в аналитике.
Это руководство о том, как измерить эту комнату: есть ли вы в ней, на каком месте, кто стоит рядом и сколько людей на самом деле доходит от ответа до вашего сайта. Оно написано для маркетологов и владельцев сайтов, а не для специалистов по данным, и всё описанное можно сделать вручную на нескольких вопросах, прежде чем что-то автоматизировать.
Что такое видимость в ответах ИИ
Видимость в ответах ИИ показывает, в какой доле покупательских вопросов модель называет ваш бренд. Её считают отдельно по каждому вопросу, каждой модели и каждому конкуренту: назван ли бренд вообще, на каком месте, со ссылкой или без и кто назван рядом.
Последнее важно. В поиске есть десять ссылок и ваша позиция среди них. В ответе ИИ два-три названия или ни одного. Второй страницы, с которой можно подняться, нет. Либо бренд есть в рабочем наборе модели для этого вопроса, либо его нет, и причина обычно не та, о которой вы думаете.
Начинайте с вопросов, а не с ключевых слов
Список ключевых слов здесь не годится как сырьё. Никто не пишет в ChatGPT «веб-аналитика 152-ФЗ». Люди задают вопрос с ситуацией внутри, и ситуация меняет ответ.
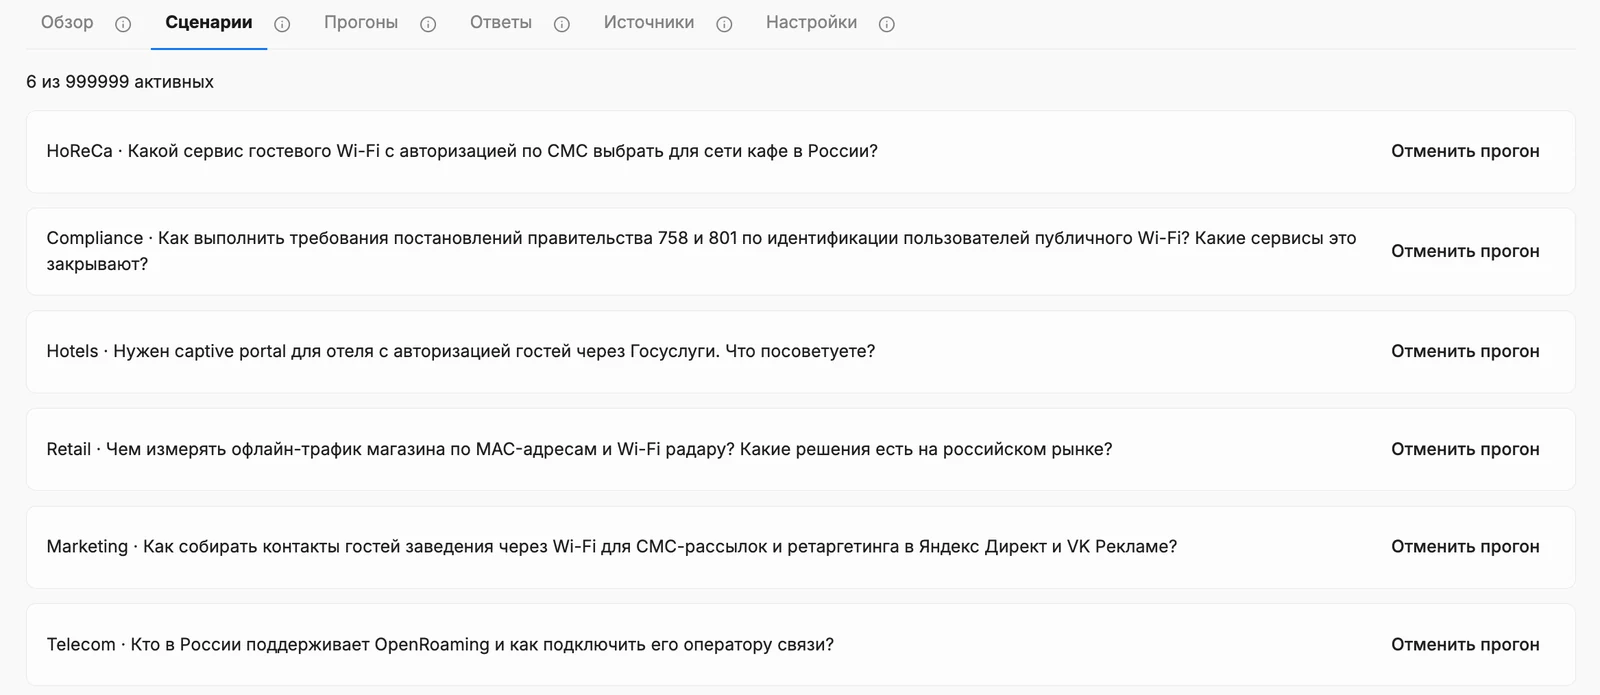
Поэтому первый шаг — список сценариев спроса: вопросов, которые ваши покупатели задают на самом деле, сгруппированных по тому, кто спрашивает и чего хочет. Большинству компаний хватает двадцати-тридцати сценариев. Вот как выглядит фрагмент такого списка для компании, которая продаёт эргономичные офисные кресла:
| Сегмент | Намерение | Как спросит покупатель |
|---|---|---|
| Сотрудник на удалёнке | Выбрать | «Какое офисное кресло лучше при болях в спине, если сидишь по восемь часов?» |
| Сотрудник на удалёнке | Сравнить | «Стоит ли кресло за 40 000 ₽ своих денег по сравнению с креслом за 15 000 ₽?» |
| Офис-менеджер | Купить оптом | «Где заказать 40 эргономичных кресел с доставкой по Москве?» |
| Офис-менеджер | Доверие | «У каких брендов эргономичных кресел гарантия пять лет и больше?» |
| Любой | Рядом | «Шоурум эргономичных кресел в Санкт-Петербурге» |
Здесь важны три вещи. Пишите вопросы так, как их набрал бы человек, включая корявые. Включайте сценарии, где вы ожидаете проиграть: именно они чему-то учат. И держите список неизменным между замерами. Если менять вопросы каждый месяц, вы измеряете не изменения, а собственные правки.
Задавайте каждый вопрос больше одного раза
Этот шаг пропускают чаще всего, и именно он решает, значат ли ваши цифры хоть что-нибудь.
Языковые модели недетерминированы. Задайте один и тот же вопрос три раза и получите три разных ответа: иногда бренд есть во всех трёх, иногда в одном. Единичный прогон — это подброшенная монетка, оформленная как отчёт.
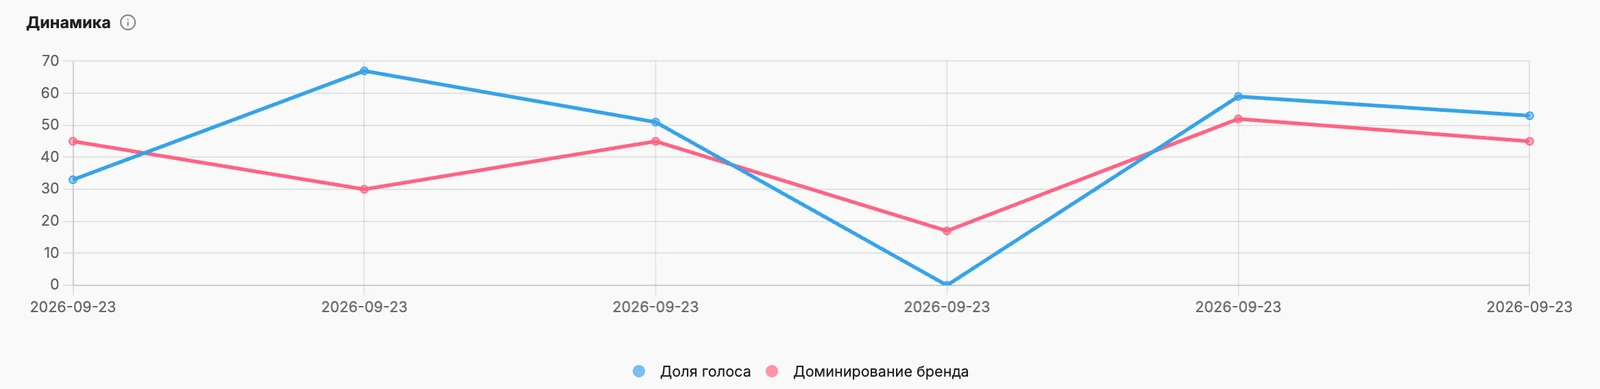
Лекарство скучное: задавайте каждый вопрос несколько раз за прогон (три — разумный минимум) и показывайте разброс рядом со средним. Ваша доля упоминаний не «58 %», а «58 % ± 9 пунктов». Если в следующем месяце получилось 63 %, это внутри шума. Если 78 %, что-то действительно произошло.
Полезное правило: рост считается ростом, только если он больше разброса. Каждый, кто хоть раз показывал слайд «+8 %», который испарился на следующем прогоне, поймёт почему.
Семь показателей, которые стоит отслеживать
Когда ответы собраны, текст нужно превратить в числа. Эти семь показателей покрывают почти всё, о чём спросит маркетинг, и у каждого простое определение: на небольшом наборе его можно посчитать вручную.
| Показатель | На какой вопрос отвечает | Как считать |
|---|---|---|
| Упоминания | В какой доле ответов бренд назван вообще? | Ответы с брендом ÷ все ответы |
| Позиция | Назван первым или последним в списке? | Среднее и медиана места бренда среди названных брендов |
| Ссылки | Как часто упоминание идёт со ссылкой на ваш сайт? | Ответы со ссылкой на ваш домен ÷ все ответы |
| Рекомендация | Модель советует вас или просто перечисляет? | Ответы, где модель прямо советует бренд ÷ все ответы |
| Индекс доминирования | Какова ваша доля в ответах против конкурентов? | См. ниже |
| Корректность | Когда модель говорит о вас, факты верны? | Ответы без фактических ошибок о бренде ÷ ответы, где он упомянут |
| Разброс | Насколько стабильно всё перечисленное? | Разброс доли упоминаний между повторами одного вопроса |
Об индексе доминирования стоит сказать отдельно. Один из способов его построить: каждый ответ даёт бренду до четырёх баллов, по одному за упоминание, первое место, ссылку и рекомендацию. Ваш индекс — это ваши баллы, делённые на баллы всех брендов в тех же ответах, умноженные на 100. В сумме по всем брендам получается 100, поэтому индекс ведёт себя как доля рынка и читается так же.
Пример из живого прогона 24 сентября 2026 года для WiFly, сервиса гостевого Wi-Fi: индекс доминирования 55 против примерно 28 у Hot-WiFi, доля голоса 61 %, ссылка на сайт в 58 % ответов. По такой цифре сразу понятно, за кого модели хватаются первым.
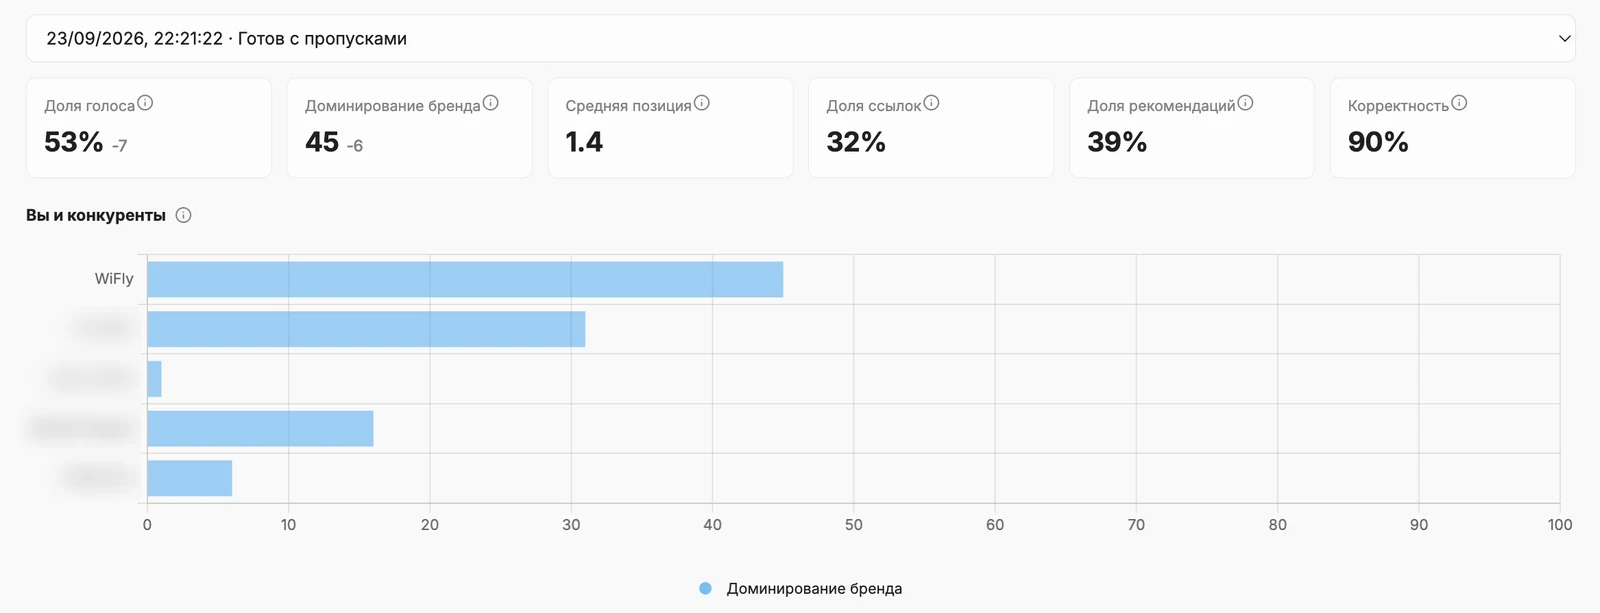
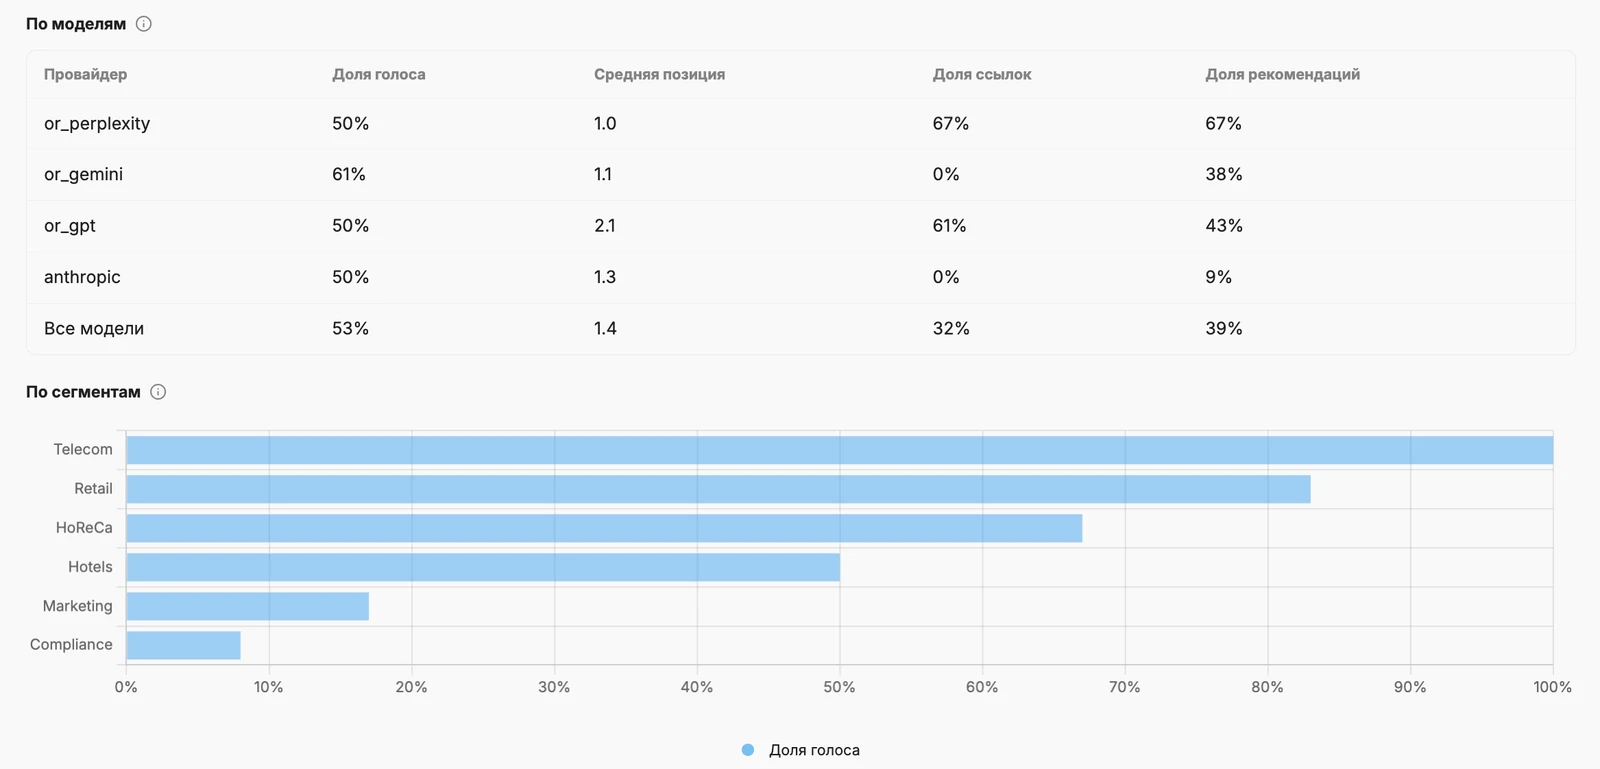
Ведите все семь показателей по каждой модели отдельно, а не только в среднем. Одни модели ссылаются почти в каждом ответе, другие почти никогда. Усреднённая «доля ссылок» прячет эту разницу, а вместе с ней и решение, куда вкладываться.
Храните ответы, а не только проценты
Сохраняйте каждый ответ целиком, со всеми ссылками, которые привела модель. Звучит как деталь хранения. На деле это самое полезное решение во всём методе, и причин три.
Во-первых, любую цифру можно проследить до текста, из которого она получилась. Когда спрашивают, почему упала корректность, вы открываете ответы и читаете, в чём модель ошиблась. Обычно это старая цена, снятый с продажи товар или утверждение конкурента, поданное как факт.
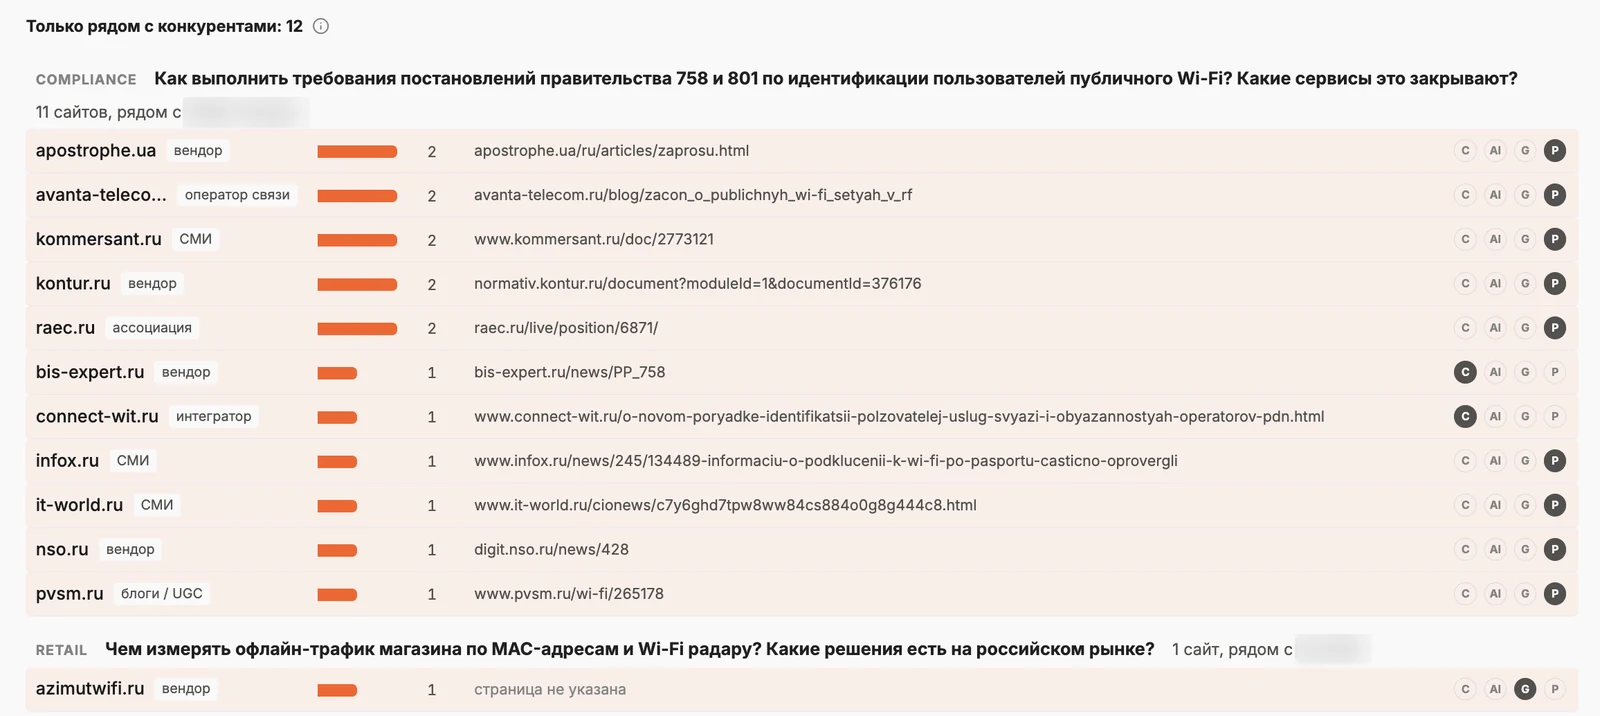
Во-вторых, видно, кто занял ваше место. В ответах, где вашего бренда нет, модель на что-то сослалась: сайт-сравнение, карточку на маркетплейсе, ветку на форуме, гайд конкурента. Список этих страниц, отсортированный по частоте, и есть ваш план работы за пределами сайта. У WiFly в одном сценарии про постановления 758 и 801 модели сослались на десять сайтов, от «Коммерсанта» до «Контура», и все десять стояли рядом с конкурентом. Готовый список для PR и единственный честный ответ на вопрос «почему они, а не мы».
В-третьих, история пересчитывается бесплатно. Добавили забытого конкурента или написание бренда, которое использует модель (латиницей, кириллицей, в другом падеже), и все прошлые прогоны пересчитаны из сохранённых ответов. Без новых прогонов, без разрыва в тренде, без затрат.
Почему цифра именно такая
Теперь неудобная часть. Низкая видимость почти всегда упирается в технику, и её не видно из браузера: сайт выглядит нормально, потому что вы не ИИ-краулер.
Прежде чем писать новые страницы, проведите семь проверок. Они отвечают на вопрос «почему» рядом с вопросом «сколько».
Доступ
- Пускает ли
robots.txtкаждый ИИ-краулер по отдельности?GPTBotиOAI-SearchBot,ClaudeBot,PerplexityBotиGooglebot— разные токены, и правило для одного ничего не говорит о других. Для российского рынка добавьтеYandexBot: нейро-ответы Яндекса строятся на его поисковом индексе. - Что на самом деле отдаёт сервер, когда приходит именно ИИ-краулер? Файрвол или защита от ботов может блокировать краулер, которого
robots.txtпускает, и ничего вам об этом не сообщить.
Контент
- Получает ли краулер столько же текста, сколько видит человек? Большинство ИИ-краулеров не выполняют JavaScript, Googlebot выполняет. Если описания товаров рисуются на стороне клиента, краулер получает скелет.
- Читается ли текст вообще без JavaScript: заголовки, цены, адреса, в том HTML, который отдаёт сервер?
Бренд
- Говорит ли разметка, чей это сайт, так, чтобы машина могла это проверить? Сущность
Organizationс названием, логотипом и ссылками на другие профили отличает «сайт про кресла» от «сайта этой компании». - Видны ли адреса магазинов и офисов текстом, или они спрятаны в виджете карты, который краулер не читает?
Соглашения
- Новые сигналы:
llms.txt, Markdown-версии страниц для агентов, заголовки Content Signals. О них стоит знать, но ни один не заменяет шесть проверок выше. Google в своём руководстве по генеративным функциям поиска прямо пишет, что такие файлы не использует.
Проверки 1, 3 и 4 делаются в терминале меньше чем за минуту. Запросите страницу товара дважды, как браузер и как краулер, и посчитайте слова:
curl -sA "Mozilla/5.0 (Windows NT 10.0) Chrome/128.0" https://example.ru/product | wc -w
curl -sA "GPTBot/1.2 (+https://openai.com/gptbot)" https://example.ru/product | wc -w
Если второе число — малая доля первого, вы нашли проблему раньше, чем конкурента. Разметку, robots.txt и sitemap отдельной страницы без терминала покажет бесплатная SEO-проверка.
Реальный пример из наших сентябрьских измерений: розничный сайт отдавал ИИ-краулеру 22 % текста, который видит человек, и ни одной строки разметки о том, какой компании он принадлежит. Снаружи обычный сайт. Для модели его почти не было.
Вторая ось: кто на самом деле пришёл
Всё, о чём шла речь выше, измеряет, что говорят модели. Но не показывает, сделал ли кто-то что-нибудь после ответа, а именно об этом спросит финансовый директор.
Трафик из ИИ-ассистентов чаще всего приходит с источником перехода: chatgpt.com, perplexity.ai, gemini.google.com, claude.ai, giga.chat, chat.deepseek.com. Почти любая аналитика складывает их в «Переходы по ссылкам» рядом со случайным блогом или теряет в «прямых заходах», когда источник обрезан. В обоих случаях вы не видите их как отдельный источник трафика, а значит, не видите ни посадочных страниц, ни поведения, ни конверсий.
Исправить нужно две вещи. Выделите ИИ-ассистентов в отдельный канал, отдельно от поиска и от обычных переходов. И честно примите ограничение: часть ассистентов не передаёт источник вообще, а Алиса приходит как обычный Яндекс и от поиска не отделяется. Поэтому этот канал — нижняя оценка, а не потолок. Зато можно сказать: «из ответов ИИ пришло как минимум столько людей, и вот что они сделали». Большинство команд сегодня не могут сказать и этого.
Положите две оси рядом, и картина становится руководством к действию. Упоминания растут, трафик из ИИ стоит: модель вас называет, но не ссылается, значит, работайте над долей ссылок. Упоминания стоят, трафик растёт: модель отправляет людей на страницу, которую вы не ждали, посмотрите на неё. Растёт и то и другое: исправления сработали, пора писать кейс.
Три вещи, которые лучше сказать сразу
У любого честного измерения есть ограничения, и лучше назвать их в начале, чем в третьем ежемесячном отчёте.
Не каждую поверхность можно измерить. ChatGPT, Claude, Gemini, Perplexity и AI Overview в Google измеряются вопросами. Нейро-ответы Яндекса сегодня не отдаёт ни один поставщик данных, поэтому они остаются вне цифр, пока не появится способ их снимать.
Блоки ИИ появляются не на каждый запрос. На одни коммерческие вопросы Google показывает AI Overview, на другие — товарную выдачу. Это результат измерения, а не ошибка. Ставьте цели по охвату относительно доли запросов, где блок вообще есть.
Модели меняются. Поставщики меняют поисковую подложку, меняется формат ответов, модель начинает ссылаться чаще или реже. Тренд через обновление модели нуждается в сноске. Сохранённые ответы (см. выше) и делают такую сноску возможной.
Ежемесячная процедура на один вечер
- Зафиксируйте список сценариев. Двадцать-тридцать вопросов, сгруппированных по сегменту и намерению. Меняйте его, только когда меняется бизнес.
- Задайте каждый вопрос три раза каждой модели, которая вам важна, в один и тот же день месяца. Сохраните ответы целиком.
- Посчитайте семь показателей по каждой модели, с разбросом рядом с каждым. Сравните с прошлым месяцем; всё, что внутри разброса, игнорируйте.
- Прочитайте ответы, где вас нет, и выпишите страницы, на которые модели сослались вместо вас. Это ваши цели для PR и контента.
- Повторите семь проверок готовности на страницах, которые модель должна цитировать. Исправьте и измерьте снова.
- Посмотрите на канал ИИ-ассистентов в аналитике: визиты, посадочные страницы, конверсии. Свяжите любое движение с показателями выше.
Сделайте это вручную один месяц, и вы будете знать о своей видимости в ИИ больше, чем большинство конкурентов. После этого захочется всё автоматизировать.
Как это делает WebMetrics
Модуль AI Visibility выполняет этот метод за вас. Он задаёт ваши сценарии спроса ChatGPT, Claude, Gemini, Perplexity и AI Overview в Google по расписанию, каждый по нескольку раз, и сохраняет каждый ответ вместе с источниками. Он считает упоминания, позицию, ссылки, рекомендации, корректность и индекс доминирования по каждой модели, сценарию и конкуренту, с разбросом рядом с каждой цифрой и списком страниц, которые заняли ваше место. Проверки готовности запускаются на тех страницах, которые должны цитироваться. А поскольку модуль живёт внутри анализа источников трафика, переходы из ИИ-ассистентов видны отдельным каналом рядом с поиском, с посадочными страницами и конверсиями.
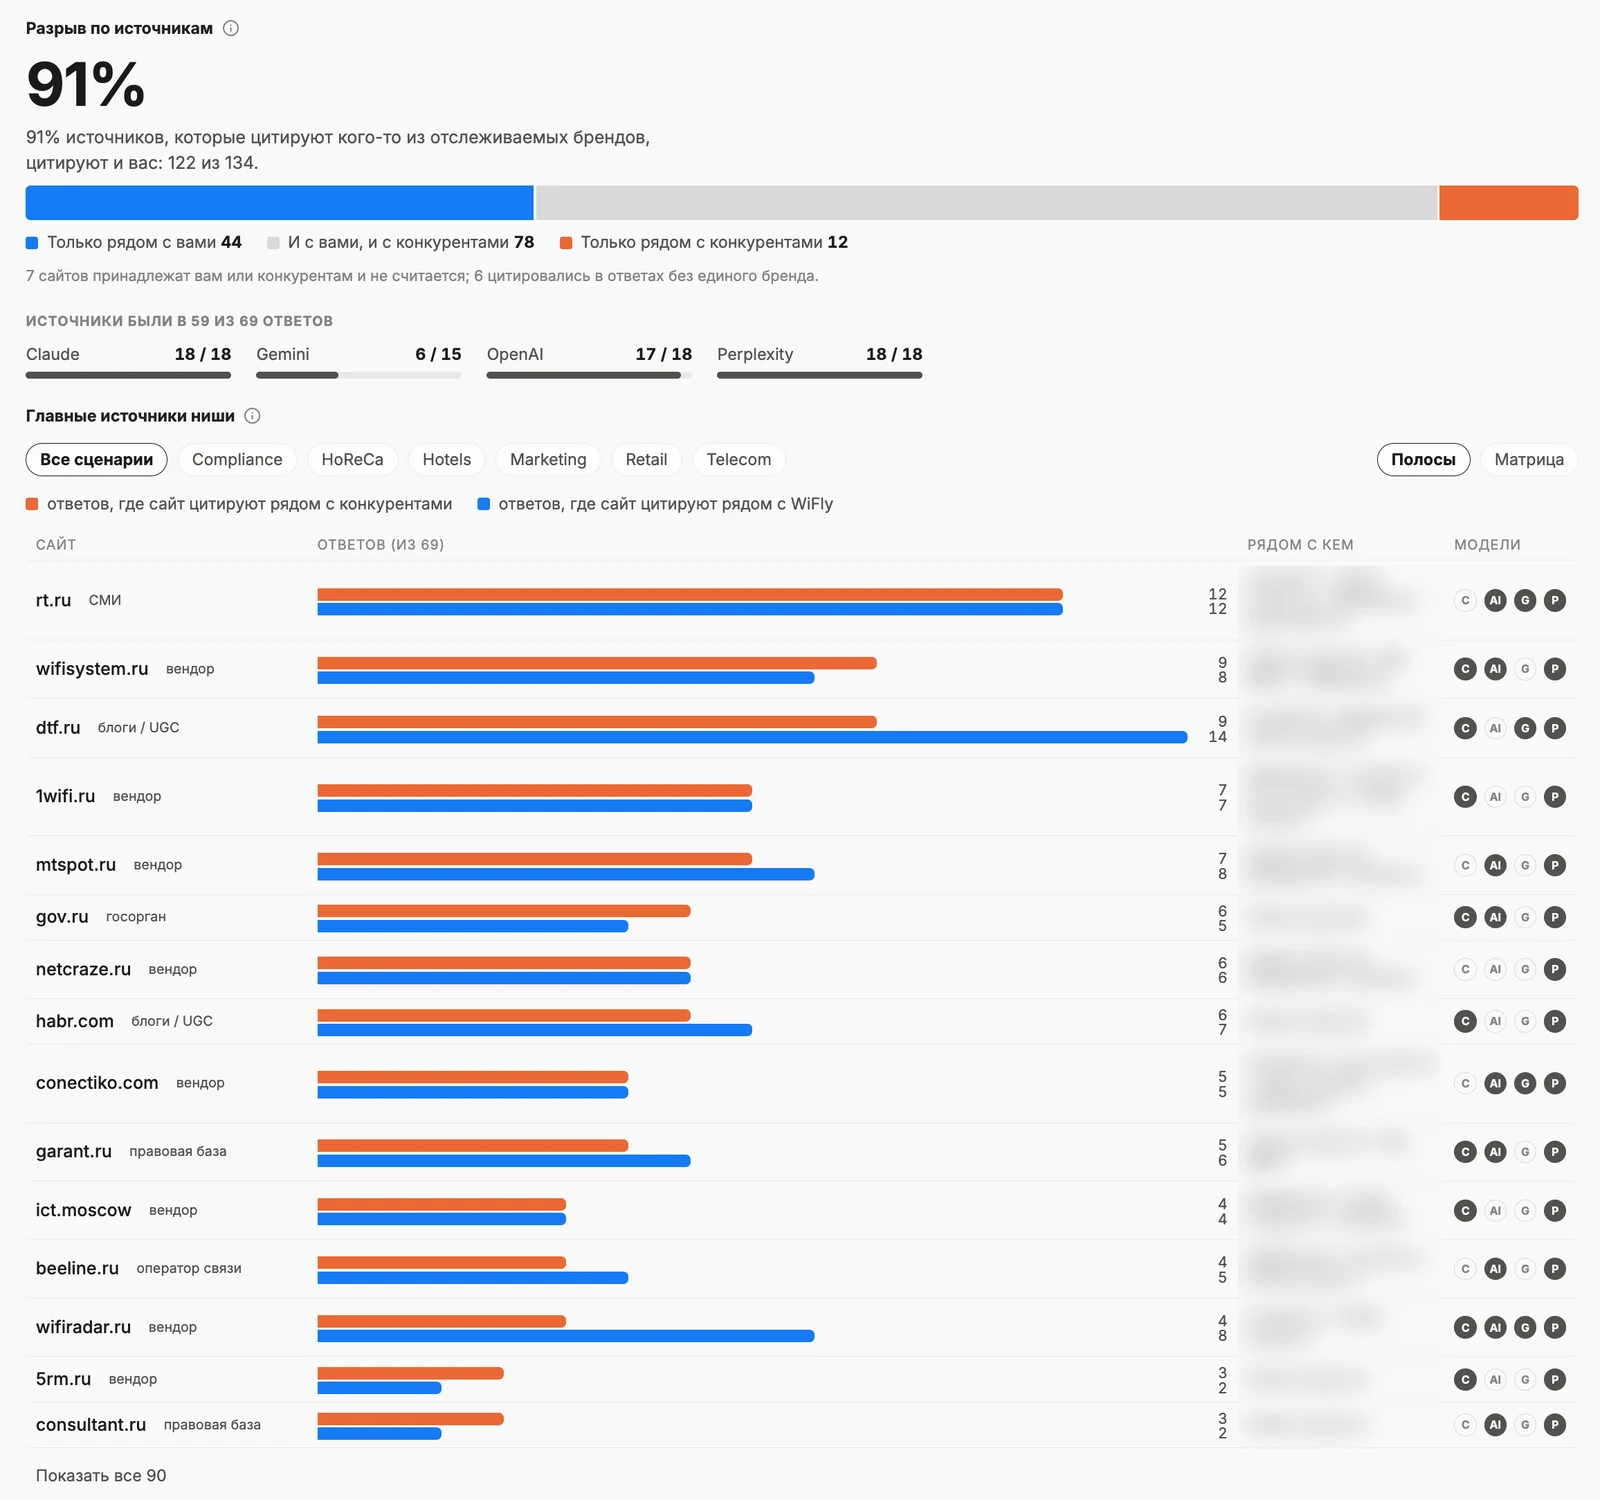
Один продукт, две оси: есть ли вы в ответе и что это принесло.
Хотите увидеть, как ваш бренд выглядит в ответах ИИ?
Запросить первый замер →
Вопросы, которые нам задают
Это то же самое, что AEO или GEO?
AEO (оптимизация под ответные системы) и GEO (оптимизация под генеративный поиск) — это работа над тем, чтобы страницы чаще цитировали. Здесь описано измерение, которое показывает, даёт ли эта работа эффект: табло, а не план игры. Нужно и то и другое, но табло раньше.
Сколько сценариев и повторов действительно нужно?
Для одного бренда на одном рынке 20–30 сценариев по три повтора на четырёх-пяти моделях дают устойчивую месячную картину, примерно 300–450 ответов за прогон. С меньшим числом сценариев цифры скачут, с меньшим числом повторов они ничего не значат. Больше имеет смысл, только когда первый набор стабилен.
Можно ли делать это в приложении ChatGPT, а не через API?
Для первого взгляда да, и это хороший способ набить руку. Для тренда нет: приложение добавляет персонализацию и память, которые меняют ответы между пользователями и сессиями, так что два человека с одним и тем же вопросом получат разные табло. Измерению нужны одинаковые нейтральные условия каждый раз.
Почему модели так расходятся?
У них разные поисковые индексы, разные правила отбора источников и разные привычки ссылаться. В прогоне WiFly 24 сентября 2026 года Claude дал ссылку на сайт в 94 % ответов, а Gemini ни в одном. Поэтому показатели ведутся по каждой модели отдельно: среднее по всем прячет ровно те различия, на которые вы стали бы реагировать.
📊 Описанный в статье модуль AI Visibility открыт в WebMetrics по запросу: что он измеряет, какие модели поддерживает и что входит в тариф, смотрите на странице видимость бренда в ответах ИИ.